
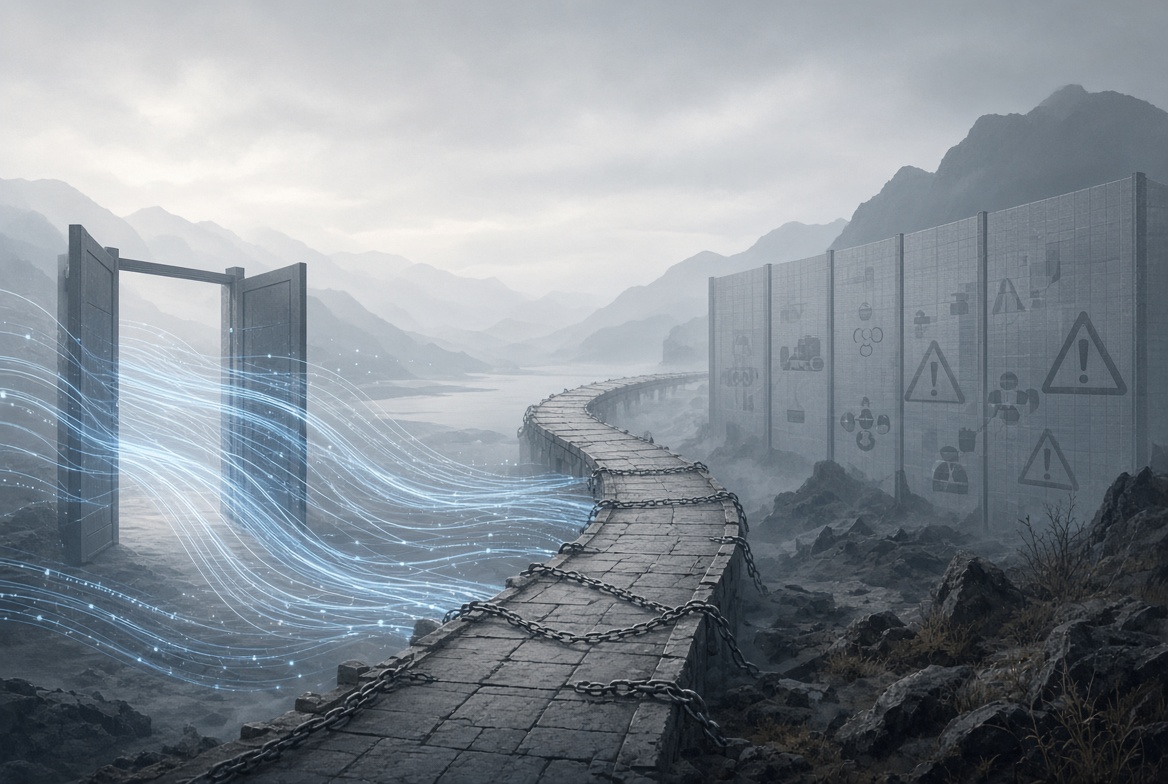
日本のAI開発が相対的に遅れている理由の一つとして、「規制とイノベーションのジレンマ」が挙げられます。法律の条文だけを見るとAI学習に優しい国である一方で、実際のビジネス現場では慎重になりやすいという、日本特有のねじれが存在します。この点について、わかりやすく整理します。
著作権法(第30条の4)が柔軟と言われる理由
日本の著作権法第30条の4は、2018年の改正で導入された規定です。この規定により、著作物を「享受する」(作品を楽しんだり、その表現そのものを味わったりする)目的ではなく、「情報解析」のために使う場合は、原則として著作権者の許諾なしに利用できます。
主なポイント
- 「情報解析」には、大量のデータから言語・画像・音などの要素を抽出して解析する行為が含まれ、AIの機械学習(学習データとしての利用)はこれに該当すると解釈されています。
- 営利目的でも対象になり、利用の方法も比較的広く認められます。
- 文化庁も、開発・学習段階での利用は原則としてこの規定が適用されるという考え方を示しています。
EUのような「権利者がオプトアウトできる」仕組みがなく、米国のフェアユースよりも条文上は明確で広い範囲をカバーしているため、「世界でもAI学習に寛容な法制度」と評価されることが多いです。
ただし、完全に自由なわけではありません。「享受目的が併存している場合」(意図的に特定の作品を再現させるような過学習など)や、「著作権者の利益を不当に害する場合」には適用されません。この点がグレーゾーンとして残っています。
それでもブレーキがかかりやすい理由
学習段階の法制度は柔軟である一方で、実際にサービスを事業として展開しようとすると、次のような要因で慎重になりやすい雰囲気があります。
個人情報保護法の壁
著作権はクリアできても、学習データや利用データに個人情報が含まれる場合、個人情報保護法のルールが別途かかります。従来は「利用目的の特定」や「本人同意」が厳しく求められ、AI学習のために第三者の個人データを広く集めて使うのが実務上ハードルになりやすい、という指摘が続いていました。
2026年頃に改正が進み、統計作成やAI開発目的で一定の条件を満たせば同意なしに個人データを利用・提供しやすくする方向の特例も設けられています。しかし、完全に自由になったわけではなく、透明性の確保や安全管理、漏洩時の責任などが議論の対象になっています。企業からすると「条文上は緩和されても、運用や説明責任で詰まる」状況が残ります。
社会的な倫理議論と空気
法律で明確に禁止されていなくても、「プライバシーが心配」「クリエイターの仕事を奪うのでは」「ディープフェイクなどの悪用が怖い」といった社会的な懸念が強く出やすいのが日本の特徴です。企業は、法的リスクだけでなく、炎上やブランド毀損を警戒して、積極的な展開を控える傾向があります。
特に生成AIの普及後は、権利者団体からも「学習は認められても、市場への影響は考慮してほしい」という声が上がり、政府も罰則付きのハードな規制ではなく、ガイドラインやソフトな枠組みで対応する姿勢を取っています。結果として、「やっていいのかどうか、どこまでやっていいのか」が現場で判断しにくくなり、慎重論が強まりやすい構造になっています。
ジレンマの本質
簡単に整理すると、次のようになります。
- 学習段階の法制度:著作権については世界的に見ても柔軟で、「データを集めて学習する」こと自体は比較的やりやすい。
- 事業化・展開段階:個人情報の扱い、社会的な納得感、倫理的な説明責任などで「実際にサービスを出して広げる」ところにブレーキがかかりやすい。
法律で門を広く開けておきながら、社会的な受容や実務上のコンプライアンス意識が追いつかず、結果として「動けるけど動きにくい」状態になっている、というのがこの「規制とイノベーションのジレンマ」の意味です。
この点は、他の国(特に米国や中国)の「まずは出してから直す」スピード感と比べたときに、よく指摘されるポイントです。条文上の柔軟さと、現場での慎重さが同時に存在する構造が、日本のAI開発の遅れの一因となっていると考えられます。
コメント